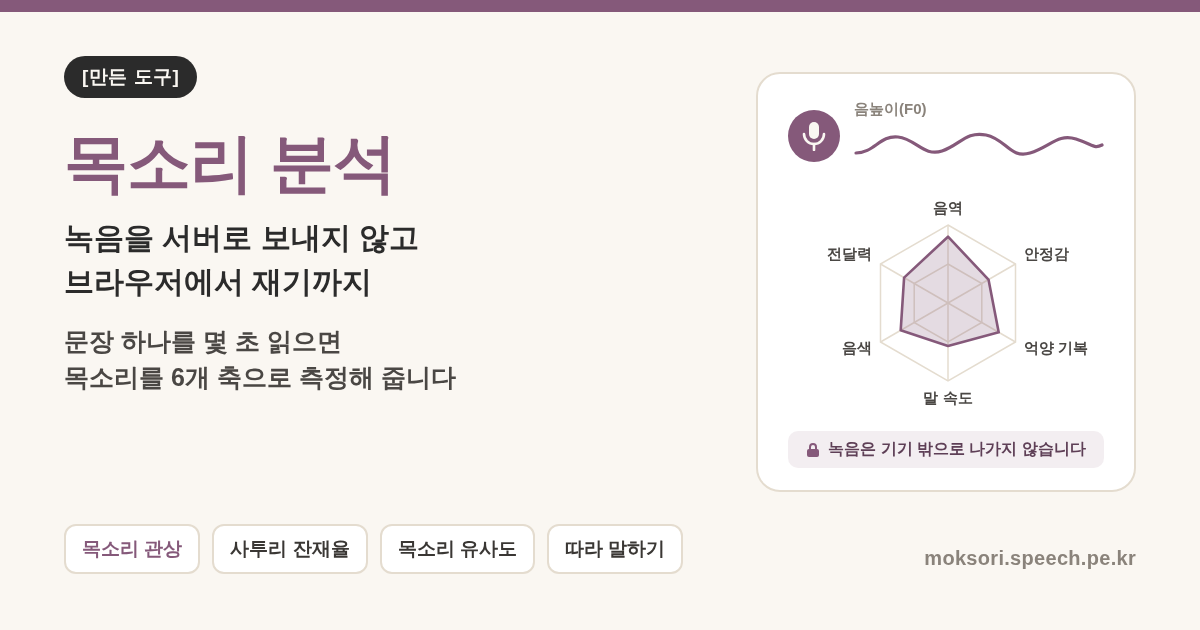
✅ 결론부터 적으면, 목소리 분석(moksori)은 문장 하나를 몇 초 읽으면 목소리를 주파수 단위로 측정해 주는 도구입니다. 녹음은 서버로 보내지 않습니다. 분석은 전부 브라우저 안에서 끝납니다. 이 글은 그 도구를 왜, 어떻게 만들었는지에 대한 기록입니다. 다만 같은 사이트에 들어 있는 웨이크워드 ‘일어나’ 기능은 아직 개발 단계입니다.
1. 왜 만들었나
“내 목소리는 남에게 어떻게 들릴까”는 누구나 한 번쯤 궁금해하는 질문입니다. 그런데 이런 류의 서비스는 대개 녹음을 서버로 올려야 결과를 줍니다. 재미로 해 보는 테스트에 내 목소리를 남의 서버에 맡기는 건 꺼림칙했습니다.
그래서 범위를 좁혔습니다. 녹음이 기기 밖으로 나가지 않는 것, 이것 하나만은 타협하지 않기로 했습니다. 서버가 없으니 큰 AI 모델은 못 씁니다. 대신 오래 검증된 신호처리 알고리즘을 브라우저에서 직접 돌리는 쪽을 택했습니다. 첫 커밋은 2026년 8월 17일입니다.
2. 무엇을 하는 도구인가
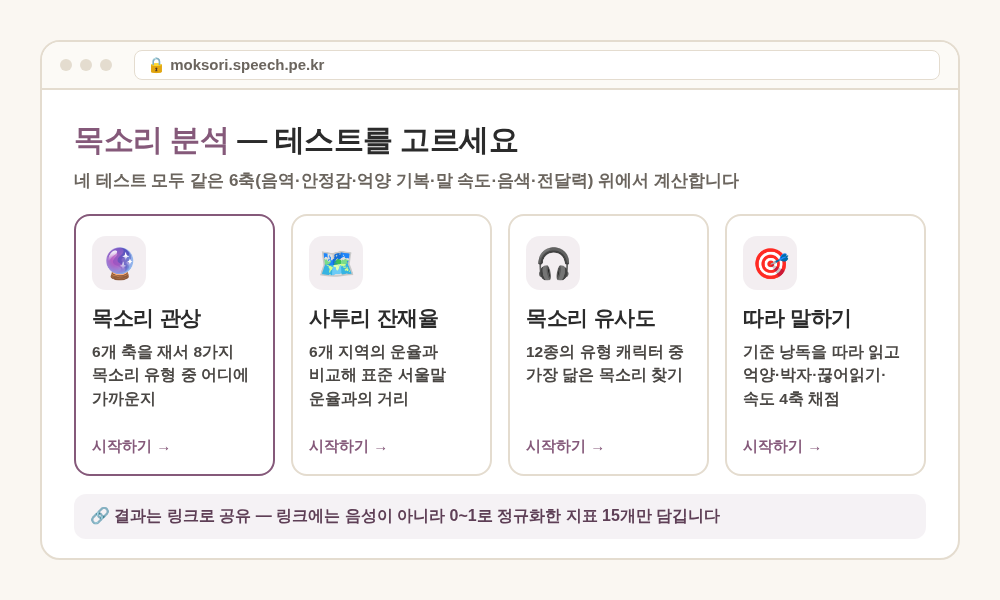
지금 바로 쓸 수 있는 테스트는 4가지입니다.
| 테스트 | 하는 일 |
|---|---|
| 🔮 목소리 관상 | 6개 축을 재서 8가지 목소리 유형 중 어디에 가까운지 알려 줍니다 |
| 🗺️ 사투리 잔재율 | 6개 지역(서울·경기, 경상, 전라, 충청, 강원, 제주)의 운율과 비교합니다 |
| 🎧 목소리 유사도 | 12종의 유형 캐릭터 중 가장 닮은 목소리를 찾습니다 |
| 🎯 따라 말하기 싱크로율 | 기준 낭독을 듣고 따라 읽으면 억양·박자·끊어읽기·속도 4축으로 점수를 매깁니다 |
유사도 비교 대상은 실존 인물이 아닙니다. “새벽 라디오 진행자”, “메인 뉴스 앵커”, “e스포츠 캐스터” 같은 유형 캐릭터입니다. 실제 인물과 비교하려면 기준 음성이 필요하고, 초상권·음성권 문제도 따라오기 때문입니다.
⚡ 네 테스트는 모두 같은 6축 위에서 계산합니다. 음역·안정감·억양 기복·말 속도·음색·전달력입니다. 판정 모델들이 같은 좌표를 공유하니, 관상 결과와 유사도 결과가 서로 엇갈리지 않습니다.
결과는 링크로 공유할 수 있습니다. 이 링크에는 음성이 아니라 0~1로 정규화한 지표 15개만 담깁니다. 링크를 열면 같은 결과가 다시 그려집니다.
3. 어떻게 만들었나
서버 없이, 브라우저가 강제하게
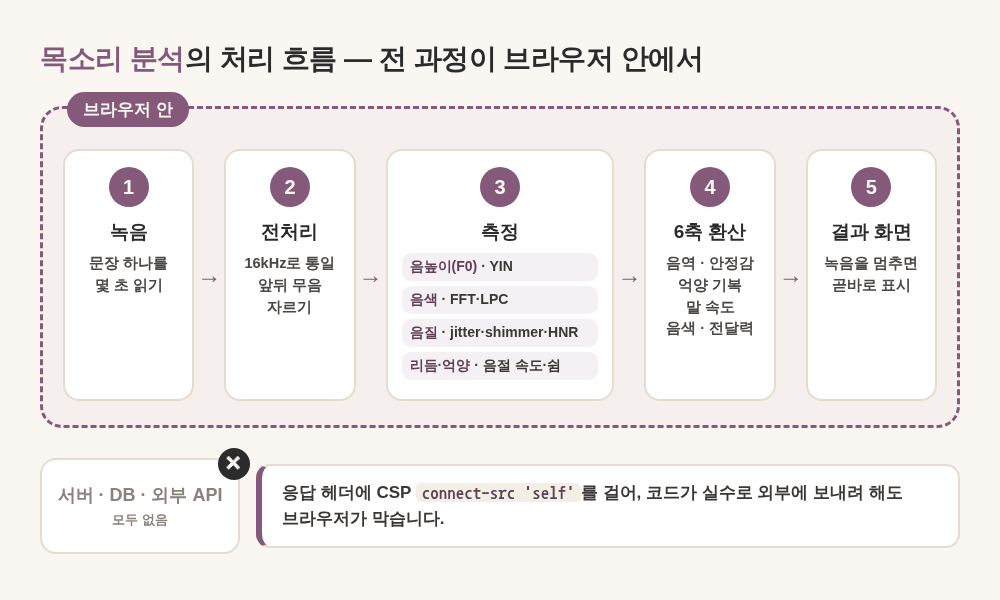
사이트는 Next.js 정적 내보내기로 만들었습니다. 서버도, DB도, 외부 API 호출도 없습니다. 신호처리 파이프라인 전체를 TypeScript로 직접 구현했습니다. 필요한 조건은 마이크 사용을 위한 HTTPS 하나입니다.
“아무것도 안 보낸다”는 말을 약속으로만 두지 않았습니다. 응답 헤더에 CSP connect-src 'self'를 걸었습니다. 그래서 코드가 실수로 외부에 뭔가 보내려 해도 브라우저가 막습니다. 업로드 왕복이 없으니 녹음을 멈추면 결과가 곧바로 나옵니다.
브라우저의 음성 후처리도 일부러 껐습니다. 잡음 억제는 고역을 깎아 음색 측정을 비틉니다. 자동 게인은 성량 차이를 지워 전달력 축을 무의미하게 만듭니다.
측정은 이렇게 합니다
- 전처리 — 샘플레이트를 16kHz로 통일하고, 앞뒤 무음을 잘라냅니다.
- 음높이(F0) — YIN 알고리즘으로 성대가 1초에 몇 번 떨리는지 추적합니다.
- 음색 — FFT로 스펙트럼 무게중심을, LPC로 포먼트를 구합니다.
- 음질 — jitter, shimmer, HNR(배음 대 잡음비)을 계산합니다.
- 리듬·억양 — 음절 속도와 쉼, 그리고 내 평균 음높이 기준의 억양 곡선을 봅니다.
억양은 화자 자신의 중간 음높이를 기준으로 반음 단위로 옮겨서 봅니다. 그래야 성별이나 개인차에 휘둘리지 않습니다. 검증은 합성 신호로 했습니다. 80~440Hz 사인파에서 음높이를 1% 오차 안으로 복원하는지 단계별로 확인했습니다.
삽질도 있었습니다 — 평가한 경로와 배포된 경로가 달랐다
웨이크워드를 만들 때 일입니다. ‘일어나’를 알아듣는 작은 신경망(TDNN)을 만들었습니다. 파라미터 19,425개짜리라 외부 ML 라이브러리 없이 브라우저에서 직접 돌립니다. 오프라인 평가로 판정 임계값까지 정하고 “완료”로 넘겼습니다.
그런데 실제 브라우저에서 켜 보니 20초가 지나도 깨어나지 않았습니다. 원인은 리샘플 함수였습니다. 마이크 소리는 128샘플씩 잘게 들어옵니다. 그런데 리샘플 함수가 상태를 기억하지 못해, 조각마다 위상이 0으로 돌아갔습니다. 그 결과 조각 경계마다 신호가 미세하게 어긋났습니다.
더 뼈아픈 건 따로 있었습니다. 학습·평가 스크립트는 ffmpeg로 처음부터 16kHz 파일을 읽었습니다. 즉 이 리샘플 코드를 한 번도 거치지 않았습니다. 평가한 경로와 실제 배포되는 경로가 달랐던 셈입니다.
그래서 상태를 유지하는 스트리밍 리샘플러로 고쳤습니다. 평가도 실제 스트리밍 경로를 그대로 타도록 다시 만들었습니다. 배운 점은 하나입니다. 검증은 사용자가 실제로 지나가는 길로 해야 한다는 것입니다.
4. 어떻게 쓰나
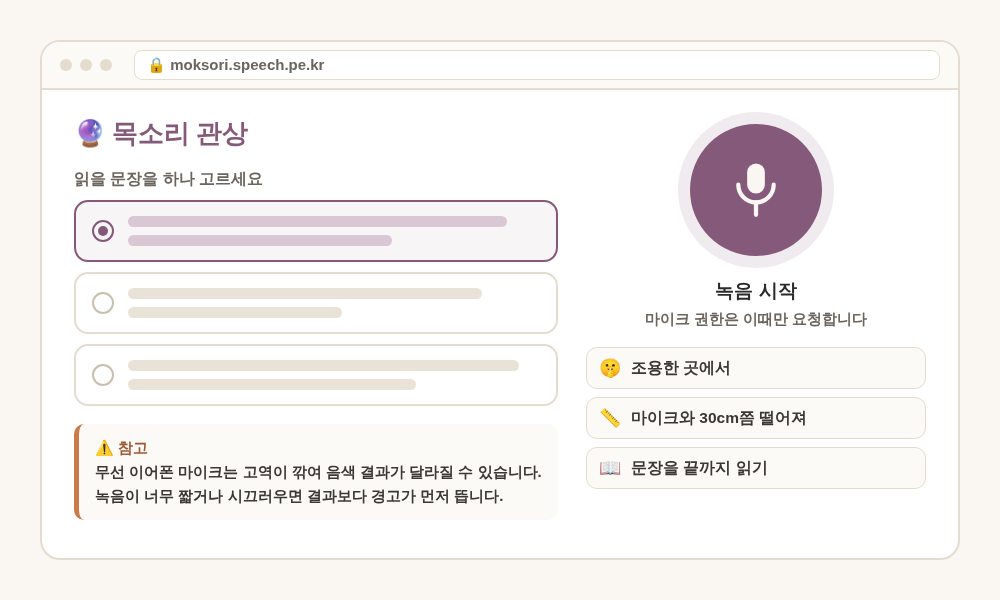
- https://moksori.speech.pe.kr/ 에 들어가 테스트를 고릅니다.
- 화면에 나온 문장 중 하나를 고릅니다.
- 녹음 버튼을 누릅니다. 마이크 권한은 이때만 요청합니다.
- 조용한 곳에서 마이크와 30cm쯤 떨어져, 문장을 끝까지 몇 초간 읽습니다.
- 결과를 확인하고, 원하면 링크로 공유합니다.
⚠️ 무선 이어폰 마이크는 고역이 깎여 음색 결과가 달라질 수 있습니다. 문장을 끝까지 읽어야 말끝 억양도 잽니다. 녹음이 너무 짧거나 시끄러우면 결과보다 경고가 먼저 뜹니다.
5. 한계와 다음 계획
⚠️ 가장 큰 한계는 해석입니다. 측정값은 실제 물리량이지만, 그것을 성격이나 지역으로 읽는 해석은 재미를 위한 것입니다. jitter·shimmer·HNR은 음성 병리에서도 쓰는 지표입니다. 하지만 아무 마이크로 짧은 문장을 읽는 건 임상 측정 조건이 아닙니다. 건강·의학적 판단에는 쓸 수 없습니다.
- 사투리 잔재율은 운율만 봅니다. 어휘나 문법은 보지 않습니다. 출신지를 맞히는 게 아니라, 표준 서울말 운율에서 얼마나 떨어져 있는지를 잽니다.
- 따라 말하기는 발음 평가가 아닙니다. 기준 낭독이 AI 합성 음성입니다.
- 녹음이 브라우저 밖으로 나가지 않으니, 몇 명이 녹음을 끝까지 했는지 같은 통계는 구조상 알 수 없습니다.
웨이크워드 ‘일어나’는 개발 단계입니다. 합성 음성 데이터로 학습해 동작은 합니다. 합성 음성 평가에서는 수치가 괜찮게 나왔습니다. 하지만 실제 사람 목소리와 폰 마이크로는 잘 걸리지 않습니다. 이 문제는 자동화 테스트로는 보이지 않았고, 사람이 직접 말해 봐야 드러났습니다. 지금은 실제 녹음 학습 데이터를 모으는 단계에서 멈춰 있습니다. 다음 계획도 실녹음 데이터를 먼저 확보하고, 그다음 재학습하는 순서입니다.
이 시리즈의 앞 글로 SEO 진단 도구와 스피치페커 — 휴대폰 녹음을 텍스트로를 소개했습니다. 다른 도구는 이 블로그가 만든 도구들에 모아 두었습니다.