✅ 결론부터 말씀드리면, 일주일 전만 해도 “이름만 뜬” 상태였던 오픈 웨이트 모델 4종 — GLM-5.3, Ministral 8B, Tencent Hy-MT2, DeepSeek-V4-Flash-Vision-Exp — 이 이제는 컨텍스트 윈도우·가격·용도까지 구체적인 스펙으로 확인됩니다. 다만 “스펙이 좋다”와 “실제로 써보니 쓸 만하다”는 여전히 다른 문제라, 이번 글에서는 어디까지 확인됐고 어디부터가 각 회사의 자체 주장인지를 구분해서 정리해봤습니다.
1. 왜 매일 아침 모델 카탈로그를 훑고 있을까요
제가 운영 중인 n8n 자동화 model-watch-daily는 매일 아침 9시 10분에 OpenRouter의 전체 모델 카탈로그를 어제와 비교합니다. 새로 올라온 무료(:free) 모델이나, vLLM·Ollama처럼 제 컴퓨터·서버에서 직접 돌릴 수 있는 “오픈 웨이트” 모델이 보이면 텔레그램으로 알림이 옵니다.
여기서 오픈 웨이트 모델이란 학습이 끝난 모델의 가중치 파일 자체를 누구나 내려받을 수 있게 공개한 모델을 말합니다. API 과금이나 인터넷 연결 없이도 로컬에서 직접 돌릴 수 있고, 데이터가 외부로 나가지 않는다는 장점이 있습니다. Ollama는 이런 모델을 ollama run <모델명> 한 줄로 바로 실행해볼 수 있게 해주는 도구고, vLLM은 그렇게 검증한 모델을 실제 서비스 트래픽에도 버티도록 PagedAttention·Continuous Batching 같은 기술로 빠르게 서빙해주는 엔진입니다. 실무에서는 “Ollama로 빠르게 써보고, 쓸 만하면 vLLM으로 옮겨 서비스에 투입”하는 흐름이 자주 쓰인다고 알려져 있습니다.
2. 지금 바로 무료로 써볼 수 있는 모델은 어떤 게 있을까
현재 OpenRouter에서 :free 접미사가 붙어 API 키만 있으면 비용 없이 호출 가능한 모델은 총 18개입니다. NVIDIA Nemotron 계열(nano-omni-30b-a3b-reasoning, nano-30b-a3b, super-120b-a12b, ultra-550b-a55b, 3.5-content-safety, 3.5-lightning, nano-12b-v2-vl, nano-9b-v2), Google Gemma 4(26b-a4b-it, 31b-it), z-ai/glm-5.2, cohere/north-mini-code, liquid/lfm-2.5-2.6b, dots-studio/dots-3-note-preview, poolside/laguna 두 종, thinkingmachines/inkling 두 종이 목록에 있습니다.
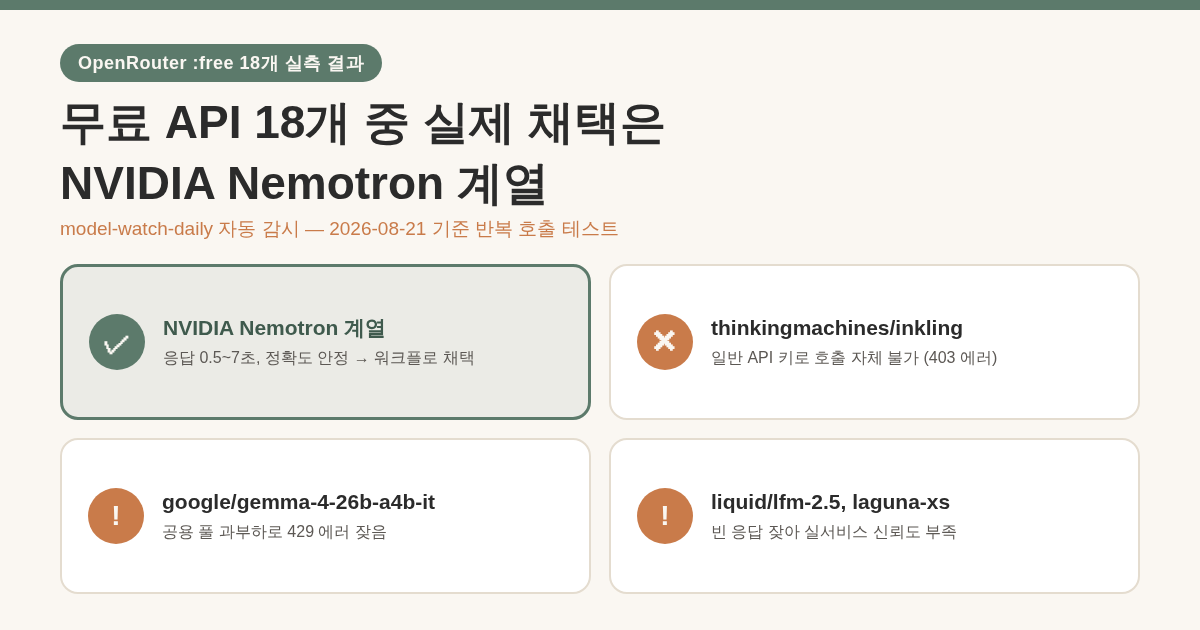
“무료”라고 다 쓸 만할까요? → 실측해보니 아니었습니다. 직접 반복 호출로 테스트한 결과, NVIDIA Nemotron 계열은 응답 속도(0.5~7초대)와 정확도가 안정적이라 실제 워크플로에 채택했습니다. 반면 thinkingmachines/inkling·inkling-small은 일반 API 키로 호출하면 “403 only available on agentic harnesses” 에러가 떠서 애초에 호출 자체가 안 됐고, google/gemma-4-26b-a4b-it는 공용 풀 과부하로 429 에러가 잦았습니다. liquid/lfm-2.5-2.6b, poolside/laguna-xs-2.1은 응답이 비어 오는 경우가 많아 신뢰도가 부족했습니다. 결국 벤더별 실측 없이 “무료” 태그만 보고 고르면 안 된다는 게 이번에도 다시 확인된 셈입니다.
3. “검증 대기” 딱지가 붙었던 신작 4종, 일주일 지나 정체가 드러났다
8월 19일 전후로 카탈로그에 새로 잡혀 원문에서는 이름만 소개했던 오픈 웨이트 모델 4종의 공개 스펙을 일주일여가 지난 지금 다시 찾아봤습니다. ⚠️ 아래는 모두 각 회사가 공개한 발표 자료 기준이고, model-watch-daily가 직접 반복 호출로 검증한 응답 속도·정확도·에러율 결과는 아직 없다는 점은 짚고 넘어가야 합니다.
z-ai/glm-5.3 — 컨텍스트 100만 토큰의 코딩·에이전트 특화 모델
Z.ai(옛 Zhipu)가 내놓은 대규모 추론 모델로, 복잡한 소프트웨어 엔지니어링과 장기 에이전트 작업을 겨냥합니다. 컨텍스트 윈도우가 100만 토큰까지 늘었고, 코딩 성능과 토큰 효율의 균형 면에서 이전 버전인 GLM-5.2보다 개선됐다고 소개됩니다. 추론(reasoning)이 항상 켜져 있어 끌 수 없고, reasoning effort는 low/high/max 세 단계 중 기본값이 max입니다. OpenRouter 가격은 입력·출력 모두 1백만 토큰당 1.20달러입니다. 다만 GLM-5.2에 이어 5.3이 이렇게 빨리 나온 배경이나 정확한 출시일까지는 이번 조사로도 확인하지 못했습니다.
mistralai/ministral-8b — 아직 정체가 확정되지 않은 슬러그
이 항목은 오히려 조사할수록 헷갈리는 쪽입니다. 오리지널 Ministral 8B는 2024년 11월 19일 공개된 80억 파라미터 모델로, 인터리브드 슬라이딩 윈도우 어텐션을 써서 엣지(온디바이스) 환경에 최적화됐고 최대 128k 컨텍스트를 지원합니다. 그런데 2025년 12월에는 비전(이미지 이해) 기능이 추가되고 컨텍스트가 262,144 토큰으로 늘어난 후속작 “Ministral 3 8B 2512″가 별도로 공개됐습니다(가격은 입력·출력 모두 1백만 토큰당 0.15달러). 원문이 감지한 mistralai/ministral-8b 슬러그가 이 둘 중 오리지널을 가리키는지, 아니면 후속작의 재노출인지는 이번 검색만으로는 확정할 수 없어 여전히 검증 안 됨으로 남겨둡니다.
tencent/hy-mt2 시리즈 — 범용 모델이 아니라 번역 전문 모델
원문에서는 이름만 나왔지만, Hy-MT2는 사실 범용 대화·코딩 모델이 아니라 Tencent가 내놓은 번역 특화 모델 계열이었습니다. 1.8B / 7B / 30B-A3B(MoE) 세 가지 크기로 나오며, 33개 언어 간 번역과 번역 지시어 수행을 지원한다고 소개됩니다. Tencent 측은 7B·30B-A3B가 fast-thinking 모드에서 DeepSeek-V4-Pro, Kimi K2.6보다 번역 품질이 앞서고, 1.8B 경량 모델도 마이크로소프트·Doubao 등 상용 API보다 낫다고 주장하는데, 이건 어디까지나 Tencent 자체 벤치마크라 제3자 재현 검증은 확인되지 않았습니다. 다행히 진입장벽은 낮은 편입니다 — 커뮤니티에서 만든 Ollama용 GGUF 변환판이 이미 두 종(kaelri/hy-mt2, maternion/hy-mt2) 올라와 있어 명령어 한 줄로 받아 테스트할 수 있습니다. 다만 vLLM은 아직 공식 릴리스에 포함되지 않아, GitHub 소스를 직접 클론해 빌드해야 하는 단계입니다.
deepseek/deepseek-v4-flash-vision-exp — 이미지까지 보는 V4-Flash
DeepSeek는 원문 관찰 시점과 같은 날인 2026년 8월 21일, DeepSeek-V4-Flash-Vision-Exp를 API 플랫폼에 정식 공개했습니다. 텍스트 능력(에이전트, 추론, 세계 지식)은 기존 DeepSeek-V4-Flash와 동등하게 유지하면서, 이미지 이해 기능이 새 입력 모달리티로 추가됐습니다. 요청당 최대 600장의 이미지, 1,048,576 토큰 컨텍스트를 지원하고 출력은 텍스트만 가능합니다. 구조는 희소 MoE로 총 2,840억 파라미터 중 130억만 활성화되는 방식이고, OpenRouter 가격은 입력 1백만 토큰당 0.22달러, 출력 0.66달러입니다. DeepSeek는 비전이 필요한 에이전트 벤치마크에서 기존 V4-Flash 대비 큰 폭으로 향상됐고 Opus-4.8에 근접한 수준이라고 밝히고 있는데, 이 역시 자체 발표 수치이고 독립 검증 결과는 아직 확인되지 않았습니다.
4. 정리
OpenRouter 카탈로그에는 이미 DeepSeek, Qwen, GLM(Z.ai), Kimi(Moonshot), MiniMax, Mistral 등 주요 오픈소스 계열 모델이 다양한 버전으로 올라와 있고, 여기에 거의 매일 새 버전이 추가되는 추세입니다. 이번에 다시 확인해보니 “이름이 떴다”에서 “스펙이 나왔다”로 넘어가는 데는 며칠이면 충분했지만, 그 스펙이 “실제로 내 워크플로에서 쓸 만하다”는 걸 확인하는 데는 여전히 별도의 실측 시간이 필요하다는 걸 다시 느꼈습니다. z-ai/glm-5.3, tencent/hy-mt2, deepseek/deepseek-v4-flash-vision-exp는 이제 로컬 또는 API로 테스트해볼 수 있는 단계에 왔으니, model-watch-daily로 실측이 끝나는 대로 다음 글에서 결과를 다시 정리하겠습니다.
관련 글: AI 영상 제작 도구 젠스파크·일레븐랩스·힉스필드·핑거 비교
이 글은 개인 서버로 업무 자동화 만들기 — Oracle Cloud + n8n + LLM 전체 지도의 6단계(LLM 붙이기)에 해당합니다. 전체 순서와 다른 단계의 기록은 가이드에서 볼 수 있습니다.